Infraestrutura
Como identificar gargalos em sua aplicação web
Meu site está lento. Como descobrir o problema?
Seu site demora para carregar, fica indisponível ou apresenta erros 502 e 504? Antes de alterar a hospedagem ou aumentar os recursos do servidor, investigue o que está causando a lentidão.
Neste artigo, vamos usar o htop para observar o consumo de CPU e memória e os processos em execução. Depois, vamos aprofundar a análise no MySQL, PHP-FPM, Nginx e Apache, cruzando consultas e logs para identificar possíveis gargalos.
Em indisponibilidade, comece pelo estado dos serviços
Confira o estado do servidor web, do PHP-FPM e do MySQL, conforme a arquitetura da aplicação. Se encontrar um serviço fora de operação, investigue sua falha e trabalhe para restabelecê-lo. Se estiverem ativos, prossiga com o diagnóstico, pois o estado do serviço sozinho não comprova que a aplicação funciona.
Esse primeiro passo se aplica à indisponibilidade. Para investigar lentidão, observe os recursos e as operações em andamento.
Observe o servidor durante a lentidão
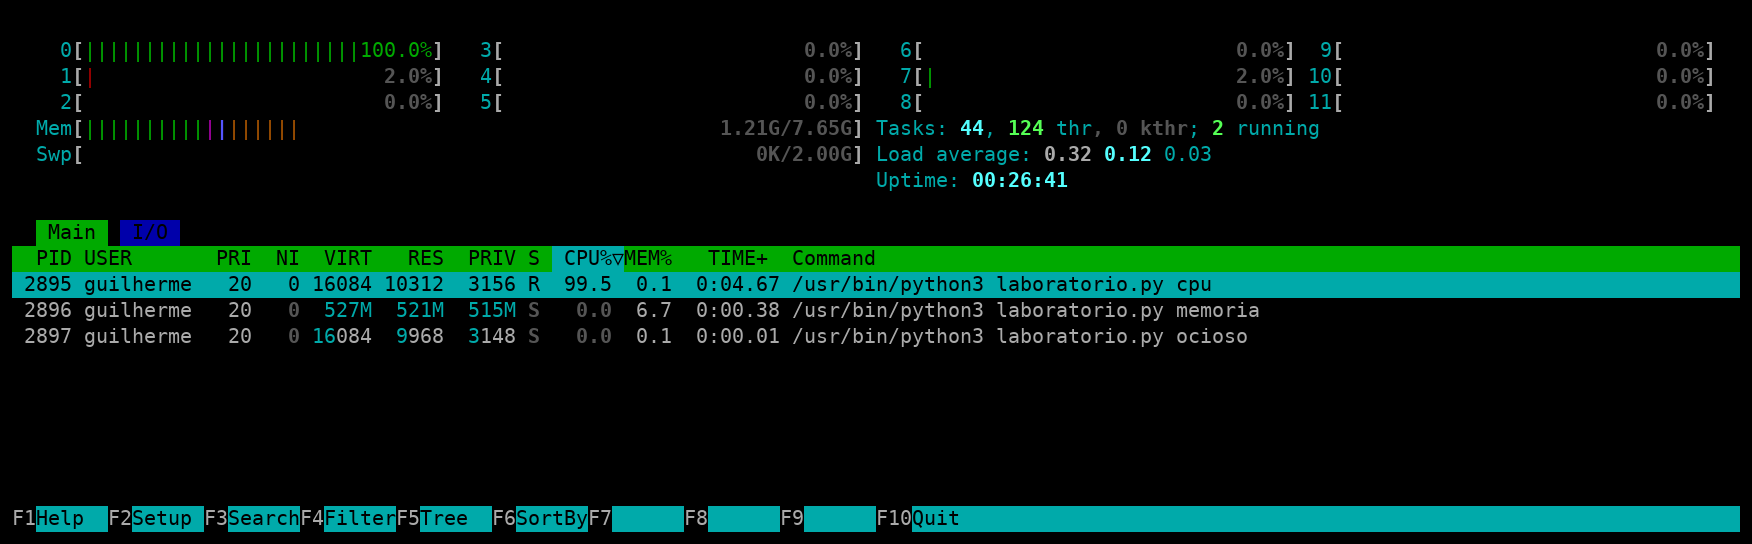
O htop permite verificar quais processos estão consumindo CPU e memória naquele momento. Ordene por CPU com P ou por memória com M e observe se o consumo coincide com a lentidão da aplicação.
Um processo PHP com CPU elevada direciona a investigação para o processamento da aplicação. O MySQL em destaque pede análise das consultas e esperas do banco. Já o crescimento de processos ou consumo do servidor web deve ser confrontado com seus logs de acesso e erro.
Registre o horário da observação. Uma captura isolada mostra o estado daquele instante, não o histórico nem a causa do problema.
Ver captura em tamanho original (nova aba)
Cruze os registros antes de atribuir a causa
Uma falha registrada pelo Nginx pode ser consequência de um problema no PHP-FPM. Um processamento PHP demorado pode estar aguardando uma consulta no MySQL. Por isso, encontrar uma mensagem de erro é o início da investigação.
Delimite o intervalo do incidente e compare os registros das camadas envolvidas. Observe horários, mensagens recorrentes, URLs e identificadores de requisição, quando disponíveis. Essa correlação ajuda a reconstruir o que aconteceu e a testar hipóteses sobre a origem da falha.
MySQL: descubra o que a aplicação está aguardando
Quando o PHP demora para responder, parte desse tempo pode estar sendo consumida na comunicação com o MySQL. Para investigar, separe três situações:
- Serviço indisponível ou reiniciando: examine o log de erros.
- Aplicação aguardando respostas do banco: consulte as operações e os estados das conexões durante o incidente.
- Operações recorrentemente demoradas: procure consultas registradas no slow query log, caso esteja habilitado.
Verifique as operações durante a lentidão
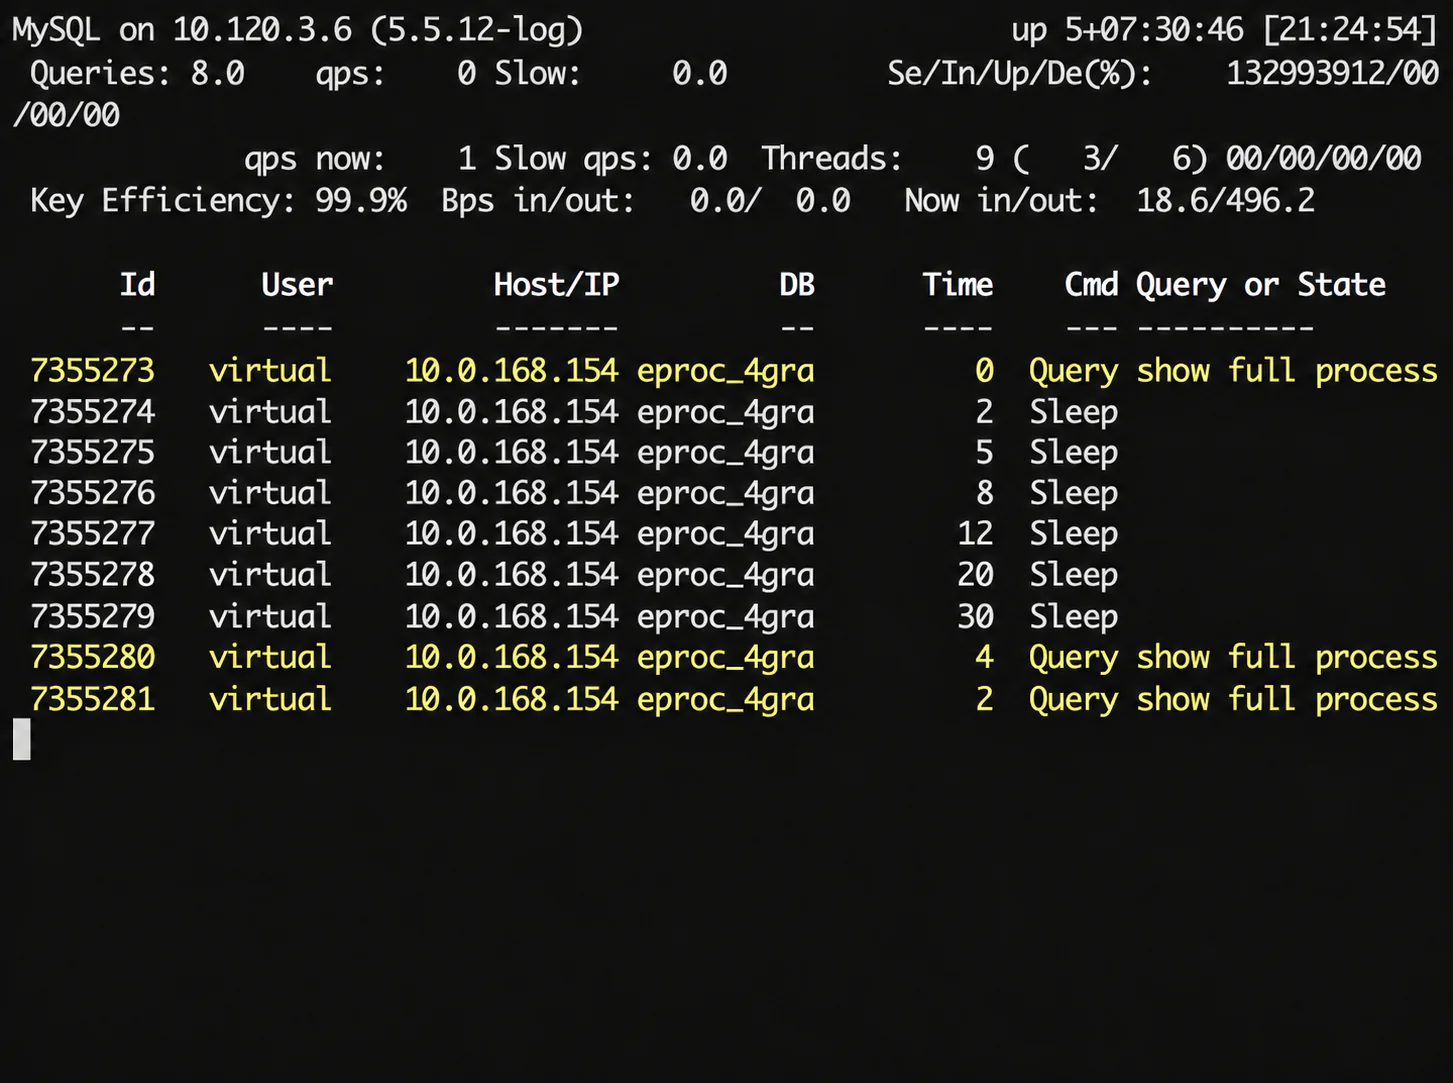
Se o htop mostrar alto consumo de memória pelo MySQL durante a lentidão, aprofunde a investigação com o mytop. Acompanhe as consultas em execução e os estados das conexões para identificar o que merece análise.
Ver imagem em tamanho original (nova aba)
Se precisar de mais detalhes sobre as conexões e as consultas em execução, execute no cliente MySQL:
SHOW FULL PROCESSLIST;
Interprete os campos em conjunto:
| Campo | O que observar |
|---|---|
Id |
Identificador da conexão no MySQL, diferente do PID exibido pelo htop. |
Command |
Atividade da conexão. Query indica processamento de um comando; Sleep indica uma sessão ociosa. |
Time |
Tempo em segundos no estado atual, não necessariamente tempo de execução de uma consulta. |
State |
Etapa de processamento ou condição de espera. |
Info |
SQL em execução, quando disponível. |
Procure operações que permanecem demoradamente no mesmo estado, comandos recorrentes e indicações de espera por bloqueios. Compare o banco, a origem da conexão e o SQL com a operação afetada na aplicação.
Uma conexão em Sleep não está executando uma consulta, mas isso não garante ausência de transações abertas ou bloqueios. A visibilidade das conexões de outros usuários depende das permissões da conta. Referência do MySQL
Localize e consulte o log de erros
Confirme o destino configurado:
SHOW GLOBAL VARIABLES LIKE 'log_error';
Caminhos comuns incluem:
/var/log/mysql/error.log
/var/log/mysqld.log
O caminho varia conforme a instalação. Se o arquivo confirmado for /var/log/mysql/error.log, consulte as últimas linhas no terminal Linux:
sudo tail -n 100 /var/log/mysql/error.log
Para acompanhar novas mensagens durante a ocorrência:
sudo tail -F /var/log/mysql/error.log
Procure eventos no horário do incidente: inicializações, encerramentos, recuperação após falhas e erros reportados pelo InnoDB. A ausência de mensagens nesse arquivo não descarta problemas de desempenho. Erros retornados às consultas também podem precisar ser investigados nos logs da aplicação.
Se log_error indicar stderr, consulte o destino que recebe essa saída, como o journal do serviço ou os logs do container. Configuração do log de erros
Em instalações com systemd que registrem esses eventos no journal, por exemplo:
sudo journalctl -u mysql.service \
  --since '15 minutes ago' \
  --no-pager
A unidade pode se chamar mysqld.service; utilize o nome correspondente à instalação. Referência do journalctl
Verifique o registro de consultas lentas
Consulte a configuração:
SHOW GLOBAL VARIABLES
WHERE Variable_name IN (
    'slow_query_log',
    'slow_query_log_file',
    'log_output',
    'long_query_time'
);
slow_query_log: informa se o registro está habilitado.slow_query_log_file: indica o arquivo configurado para a saída em arquivo.log_output: define destinos comoFILE,TABLEou ambos.long_query_time: define o limite de duração utilizado como um dos critérios de registro.
Quando houver saída em arquivo, examine o caminho retornado. Procure consultas recorrentes e compare campos como Query_time, Lock_time, Rows_sent e Rows_examined. Uma quantidade elevada de linhas examinadas em relação às retornadas é uma pista para investigar o plano de execução, não uma confirmação automática de índice ausente.
O slow query log vem desabilitado por padrão. Se não estava ativo durante o incidente, ele não terá registrado retroativamente as consultas daquele período. Referência do slow query log
PHP-FPM: descubra por que as requisições permanecem ocupadas
Uma requisição PHP pode demorar por processamento da própria aplicação ou por espera de banco de dados e serviços externos. Enquanto isso, ela pode manter um worker ocupado. Investigue os registros do pool e da aplicação para entender se existem falhas, processamento prolongado ou acúmulo de trabalho. Relacione esses eventos aos erros e tempos observados no servidor web.
Localize o serviço e os arquivos de log
Em instalações com systemd, liste as unidades correspondentes:
systemctl list-units --all --type=service 'php*-fpm.service'
Utilize o nome encontrado no lugar de <UNIDADE_PHP_FPM>:
sudo journalctl -u '<UNIDADE_PHP_FPM>' \
  --since '15 minutes ago' \
  --no-pager
O journal pode conter eventos do serviço sem concentrar todos os erros da aplicação.
Caminhos comuns, dependentes da instalação, incluem:
/var/log/php8.4-fpm.log
/var/log/php-fpm/error.log
O primeiro é um exemplo de nome com versão. Confirme o destino em error_log, na configuração do FPM, e verifique possíveis definições de php_admin_value[error_log] nos pools. O PHP também possui configuração própria de registro de erros. Configuração de erros do PHP
Se o caminho confirmado for /var/log/php8.4-fpm.log:
sudo tail -n 100 /var/log/php8.4-fpm.log
Interprete as mensagens antes de alterar limites
| Sinal encontrado | O que investigar |
|---|---|
server reached pm.max_children |
O pool atingiu seu limite de processos. Verifique duração das requisições, concorrência e capacidade disponível. Dependendo da demanda e dos recursos do servidor, pode ser necessário aumentar o número de workers por meio de pm.max_children. |
Allowed memory size ... exhausted |
A execução atingiu o limite de memória do PHP. Isso não comprova esgotamento da RAM do servidor. |
PHP Fatal error ou exceção não tratada |
Examine a mensagem completa, o arquivo, a linha e o contexto nos logs da aplicação. |
O memory_limit limita a memória que um script pode alocar; ele não representa a memória total disponível no host. Diretivas do PHP
Consulte o slowlog quando houver processamento demorado
No pool correspondente, verifique as diretivas slowlog e request_slowlog_timeout. Quando configurado e operacional, esse mecanismo registra um backtrace de requisições que ultrapassam o tempo definido, ajudando a localizar o trecho de execução.
Com request_slowlog_timeout = 0, o mecanismo está desabilitado. O slowlog não reconstitui requisições anteriores à sua ativação.
Se o pool atinge pm.max_children com frequência e há CPU e memória disponíveis, pode ser necessário aumentar o número de workers para atender à concorrência da aplicação. Antes do ajuste, investigue a duração das requisições e possíveis esperas por banco de dados ou serviços externos. Mais workers permitem maior concorrência, mas também podem elevar o consumo de memória e a carga sobre essas dependências. Configuração do PHP-FPM
Precisa de apoio nesse diagnóstico? Converse sobre sua aplicação.
Nginx e Apache: diferencie falhas de atendimento e aumento de tráfego
Quando a aplicação apresenta erros HTTP ou fica indisponível, investigue tanto as mensagens de erro quanto o comportamento do tráfego. Falhas de conexão com o PHP-FPM, respostas demoradas e crescimento de requisições exigem análises diferentes.
Uma falha registrada pelo servidor web pode começar em outra camada. O Nginx pode aguardar uma resposta do PHP-FPM enquanto o PHP espera pelo MySQL. Também pode haver problemas de conexão, permissões ou excesso de requisições. Cruze os logs de acesso e erro com os registros dos serviços envolvidos para identificar onde o atendimento falhou e direcionar a investigação.
Localize os logs utilizados pelo site
Estes são caminhos comuns, sujeitos à configuração da instalação:
| Instalação | Log de acesso | Log de erro |
|---|---|---|
| Nginx | /var/log/nginx/access.log |
/var/log/nginx/error.log |
| Apache em Debian/Ubuntu | /var/log/apache2/access.log |
/var/log/apache2/error.log |
| Apache em distribuições da família RHEL | /var/log/httpd/access_log |
/var/log/httpd/error_log |
No Nginx, confirme as diretivas access_log e error_log. No Apache, consulte CustomLog e ErrorLog. Um site pode ter arquivos próprios, diferentes dos logs gerais do servidor. Logs do Nginx, logs do Apache.
Com os caminhos confirmados, acompanhe os registros durante o problema.
No Nginx:
sudo tail -F \
  /var/log/nginx/access.log \
  /var/log/nginx/error.log
No Apache, usando os caminhos do exemplo Debian/Ubuntu:
sudo tail -F \
  /var/log/apache2/access.log \
  /var/log/apache2/error.log
Interprete as falhas de comunicação com a aplicação
No Nginx, observe a mensagem completa, especialmente a operação que estava sendo realizada:
| Mensagem ou trecho | Direção da investigação |
|---|---|
connect() failed ... Connection refused |
Verifique se o serviço de destino está ativo e aceita conexões no endereço e porta configurados. |
No such file or directory ao conectar ao upstream |
Verifique se o socket configurado existe e corresponde ao utilizado pelo PHP-FPM. |
Permission denied ao conectar ao upstream |
Examine permissões do socket e controles de acesso do sistema. |
upstream timed out |
Identifique se o timeout ocorreu ao conectar, enviar a requisição ou aguardar a resposta. Cruze com os registros da aplicação. |
Essas mensagens orientam hipóteses. Um timeout não comprova, isoladamente, que falta capacidade no Nginx: a espera pode estar no PHP, no banco ou em uma dependência externa. O módulo FastCGI possui limites distintos para conexão, envio e leitura. Referência do FastCGI no Nginx
No Apache, examine também o módulo indicado na linha de erro. Mensagens de proxy_fcgi, quando esse módulo é utilizado, direcionam a investigação para a comunicação com o backend FastCGI.
Verifique o comportamento das requisições
No log de acesso, compare:
- URLs que concentram requisições ou falhas.
- Códigos HTTP recorrentes, especialmente respostas
5xx. - Origens e padrões de repetição.
- Mudanças em relação ao tráfego habitual.
Para uma primeira amostragem, em um log no formato combined com o IP no primeiro campo, conte as origens nas últimas 10 mil linhas:
sudo tail -n 10000 /var/log/nginx/access.log |
  awk '{print $1}' |
  sort |
  uniq -c |
  sort -nr |
  head -n 20
Para contar os códigos HTTP nessa mesma amostra, considerando o status no nono campo:
sudo tail -n 10000 /var/log/nginx/access.log |
  awk '{print $9}' |
  sort |
  uniq -c |
  sort -nr
Esses comandos apresentam contagens na amostra, não requisições por segundo. Confirme o formato antes de utilizar as posições dos campos; logs personalizados podem ter outra estrutura. Para analisar o incidente, selecione o período correspondente, incluindo arquivos rotacionados quando necessário. Formato de logs do Nginx, formatação no Apache.
Quando investigar possível tráfego abusivo
Um crescimento abrupto de requisições, repetição intensa sobre determinadas rotas e degradação simultânea do serviço justificam investigar tráfego abusivo. Entretanto, volume elevado também pode resultar de acessos legítimos, integrações ou mecanismos de repetição da própria aplicação.
Se houver CDN, proxy ou load balancer, confirme qual endereço está sendo registrado. Muitas requisições atribuídas a um único IP podem pertencer ao intermediário, não ao cliente de origem. No Nginx, essa identificação depende da configuração de confiança dos proxies. Módulo Real IP
A confirmação de DDoS exige correlacionar esses sinais com métricas e eventos de rede ou da camada de proteção. Ataques que saturam a rede podem impedir que as requisições cheguem ao log HTTP. Tipos de ataque DDoS
Do diagnóstico ao dimensionamento da infraestrutura
Identificar o serviço envolvido é o início. O diagnóstico precisa relacionar os sintomas às consultas, ao processamento da aplicação, à configuração dos serviços e ao tráfego recebido. Com essas evidências, você pode definir as correções necessárias e avaliar se a capacidade disponível atende à demanda.
Se a investigação indicar necessidade de crescimento, o próximo passo é decidir como expandir. Essa decisão envolve entender quando sua infraestrutura precisa crescer e as diferenças entre escalonamento vertical e horizontal.
Oferecemos soluções e consultoria em infraestrutura para orientar decisões sobre servidores, hospedagem, desempenho e estabilidade.